fileinputformathadoop 怎么设置多个输入路径
fileinputformat 时间:2021-06-08 阅读:()
org/apache/hadoop/util/platformname 哪个jar
今天好好找了一下,这是我找到的 有关配置的conf方面在 mon/mom-2.2.0.jar .apache.hadoop.conf.Configuration org.apache.hadoop.fs.Path org.apache.hadoop.io.IntWritable org.apache.hadoop.io.Text org.apache.hadoop.util.GenericOptionsParser ) 有关Mapreduce的部分那就是在 hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar 里面了 .apache.hadoop.mapreduce.Job org.apache.hadoop.mapreduce.Mapper org.apache.hadoop.mapreduce.Reducer org.apache.hadoop.mapreduce.lib.input.FileInputFormat org.apache.hadoop.mapreduce.lib.output.FiliOutputFormat )mapreduce 可以不输出吗
支持多路输出(SuffixMultipleTextOutputFormat) 如下示例: hadoop streaming -input /home/mr/data/test_tab/ -output /home/mr/output/tab_test/out19 .apache.hadoop.mapred.lib.SuffixMultipleTextOutputFormat # 指定.apache.hadoop.mapred.lib.SuffixMultipleTextOutputFormat -jobconf suffix.multiple.outputformat.filesuffix=a,c,f,abc,cde # 指定输出文件名的前缀,所有需要输出的文件名必须通过该参数配置,否则job会失败 -jobconf suffix.multiple.outputformat.separator="#" # 设置value与文件名的分割符,默认为“#”,如果value本身含有“#”,则可以通过该参数设置其他的分隔符 -mapper "cat" -reducer "sh reduce.sh" -file reduce.sh 注:标记为红色的参数必须设置!hadoop怎么判断空值
.apache.hadoop.mapreduce.lib.input.FileInputFormat; .apache.hadoop.mapreduce.lib.output.FileOutputFormat; String?in0?=?args[0]; String?in1?=?args[1]; String?out?=?args[2]; FileInputFormat.addInputPath(job,new?Path(in0)); FileInputFormat.addInputPath(job,new?Path(in1)); FileOutputFormat.setOutputPath(job,new?Path(out));inputformat怎么解释
这几天准备好好看看MapReduce编程。要编程就肯定要涉及到输入、输出的问题。
今天就先来谈谈自定义的InputFormat 我们先来看看系统默认的TextInputFormat.java [java] view plaincopy public class TextInputFormat extends FileInputFormat<LongWritable, Text> { @Override public RecordReader<LongWritable, Text> createRecordReader(InputSplit split, TaskAttemptContext context) { return new LineRecordReader();//这里是系统实现的的RecordReader按行读取,等会我们就是要改写这个类。
} @Override protected boolean isSplitable(JobContext context, Path file) { CompressionCodec codec = new CompressionCodecFactory(context.getConfiguration()).getCodec(file); return codec == null;//而这里通过返回一个null,实际就是关闭了对当前读入文件的划分。
} } 这个类,没什么说的。
接着我们来实现我们的读取类. MyRecordReader [java] view plaincopy //我实现的功能比较简单,只要明白了原理,剩下的就看自己发挥了。
//我们知道系统默认的TextInputFormat读取的key、value分别是偏移和行,而我就简单改下,改成key、value分别是行号和行 public class MyRecordReader extends RecordReader<LongWritable, Text>{ //这里继承RecordReader来实现我们自己的读取。
private static final Log LOG = LogFactory.getLog(MyRecordReader.class); private long pos; //记录行号 private boolean more; private LineReader in; private int maxLineLength; private LongWritable key = null; private Text value = null; public void initialize(InputSplit genericSplit, TaskAttemptContext context) throws IOException { pos = 1; more = true; FileSplit split = (FileSplit) genericSplit;//获取split Configuration job = context.getConfiguration(); this.maxLineLength = job.getInt("mapred.linerecordreader.maxlength", Integer.MAX_VALUE); final Path file = split.getPath();//得到文件路径 // open the file and seek to the start of the split FileSystem fs = file.getFileSystem(job); FSDataInputStream fileIn = fs.open(split.getPath()); //打开文件 in = new LineReader(fileIn, job); } public boolean nextKeyValue() throws IOException { //这个函数会被MapRunner循环读取<key、value> if (key == null) { key = new LongWritable(); } key.set(pos); //设置key if (value == null) { value = new Text(); } int newSize = 0; while (true) { newSize = in.readLine(value, maxLineLength,maxLineLength); //读取一行内容 pos++; //行号自加一 if (newSize == 0) { break; } if (newSize < maxLineLength) { break; } // line too long. try again LOG.info("Skipped line of size " + newSize + " at pos " +
hadoop 怎么设置多个输入路径
以上的更改就是两个表进来,都可通过此类进行输入,无须针对两个表,要写两个继承FileInputFormat并实现WritableComparable接口的类。下面才是如何让才采样器只采一个文件的,啊哈!答案说出来笑死人了,那就是利用MultipleInputs先指定要采样的那个输入路径,然后调用采样器,采样结束后于采样相关的流、文件什么的进行关闭,最后再用MultipleInputs指定第二个输入路径。
这样路径一的文件(可以包含多个文本,你懂的)先采样,然后路径一和路径二的文件都进入map了,map再根据一些额外的信息判断来自那个路径的数据。
MultipleInputs.addInputPath(conf, new Path(args[0]), Definemyself.class,Mapclass.class);//第一个输入路径 /*********下面采样**********更多采样的细节见我领一篇博客,不一样的视角那篇***********/ Path input = new Path(args[0].toString()); input = input.makeQualified(input.getFileSystem(conf)); InputSampler.RandomSampler<Text, NullWritable> sampler = new InputSampler.RandomSampler<Text, NullWritable>(0.4,20, 5); /...........此处省略细节................/ IOUtils.closeStream(fs_out);// 关闭流,有关采样的结束了。
/...............此处添加一些其他的需要的工作,例如分布式缓存啦,Hashtable的处理阿............../ MultipleInputs.addInputPath(conf, new Path(args[3]), Definemyself.class, Mapclass.class); //最后指定输入的第二条路径 JobClient.runJob(conf);
- fileinputformathadoop 怎么设置多个输入路径相关文档
- fileinputformatHadoop,Combiner有什么用?
- fileinputformatmapreduce 键值对怎么定义的
- fileinputformat不同mapreduce程序可以连续运行吗?比如说多个这样的程序,用上一个的输出作为下一个的输入,求
2022年腾讯云新春采购季代金券提前领 领取满减优惠券和域名优惠
2022年春节假期陆续结束,根据惯例在春节之后各大云服务商会继续开始一年的促销活动。今年二月中旬会开启新春采购季的活动,我们已经看到腾讯云商家在春节期间已经有预告活动。当时已经看到有抢先优惠促销活动,目前我们企业和个人可以领取腾讯云代金券满减活动,以及企业用户可以领取域名优惠低至.COM域名1元。 直达链接 - 腾讯云新春采购活动抢先看活动时间:2022年1月20日至2022年2月15日我们可以在...
HostDare($33.79/年)CKVM和QKVM套餐 可选CN2 GIA线路
关于HostDare服务商在之前的文章中有介绍过几次,算是比较老牌的服务商,但是商家背景财力不是特别雄厚,算是比较小众的个人服务商。目前主流提供CKVM和QKVM套餐。前者是电信CN2 GIA,不过库存储备也不是很足,这不九月份发布新的补货库存活动,有提供九折优惠CN2 GIA,以及六五折优惠QKVM普通线路方案。这次活动截止到9月30日,不清楚商家这次库存补货多少。比如 QKVM基础的五个方案都...
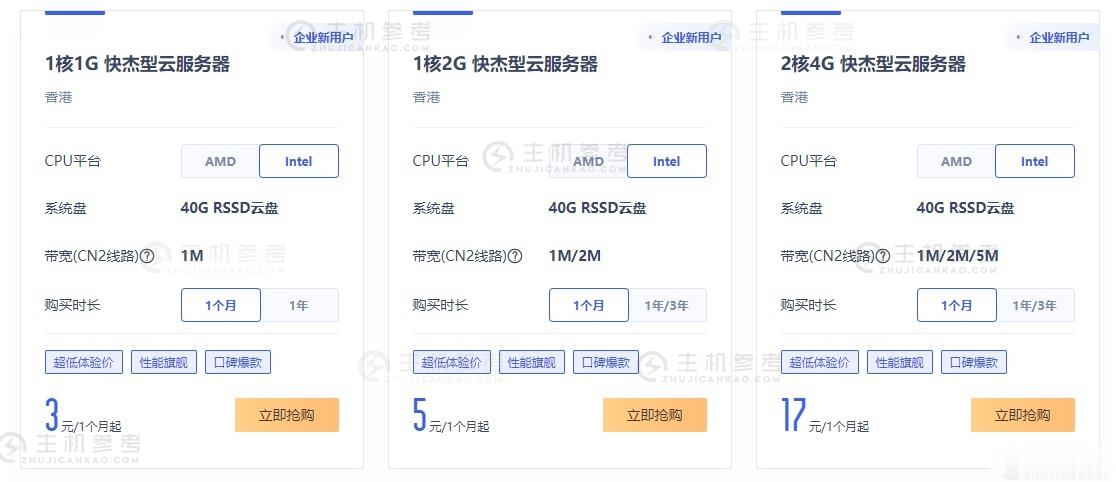
UCloud优刻得,新增1核1G内存AMD快杰云机型,服务器2元/首月,47元/年
UCloud优刻得近日针对全球大促活动进行了一次改版,这次改版更加优惠了,要比之前的优惠价格还要低一些,并且新增了1核心1G内存的快杰云服务器,2元/首年,47元/年,这个价格应该是目前市面上最低最便宜的云服务器产品了,有需要国内外便宜VPS云服务器的朋友可以关注一下。UCloud好不好,UCloud服务器怎么样?UCloud服务器值不值得购买UCloud是优刻得科技股份有限公司旗下拥有的云计算服...
fileinputformat为你推荐
-
腾讯公告官网公告是什么vga接口定义电脑显示屏VGA是什么意思awvawv格式是否等于MP4格式部署工具win10 评估和部署工具包有什么用qq网络硬盘我QQ的网络硬盘怎么啦?云计划云计划创富平台有谁了解啊 是骗人的吗?币众筹众筹是什么意思维基百科中文网站科普网页最大的谁有activitygroupTabHost ActivityGroup里面activity里的webview是不是不支持一些JS比如 alert?activitygroupActivityGroup子activity之间的切换效果怎么实现