讯代理爬虫爬虫代理服务器怎么用
讯代理爬虫 时间:2021-05-30 阅读:()
python如何学爬虫跟前端
展开全部 1:学习Python基础知识并实现基本的爬虫过程 一般获取数据的过程都是按照 发送请求-获得页面反馈-解析并且存储数据 这三个流程来实现的。这个过程其实就是模拟了一个人工浏览网页的过程。
Python中爬虫相关的包很多:urllib、requests、bs4、scrapy、pyspider 等,我们可以按照requests 负责连接网站,返回网页,Xpath 用于解析网页,便于抽取数据。
2:了解非结构化数据的存储。
爬虫抓取的数据结构复杂 传统的结构化数据库可能并不是特别适合我们使用。
我们前期推荐使用MongoDB 就可以。
3: 掌握一些常用的反爬虫技巧。
使用代理IP池、抓包、验证码的OCR处理等处理方式即可以解决大部分网站的反爬虫策略。
4:了解分布式存储 分布式这个东西,听起来很恐怖,但其实就是利用多线程的原理让多个爬虫同时工作,需要你掌握 Scrapy + MongoDB + Redis 这三种工具就可以了。
网络爬虫,用什么软件最好啊
前嗅ForeSpider数据采集系统是天津市前嗅网络科技有限公司自主知识产权的通用性互联网数据采集软件。软件具备全面的采集范围、精准的数据精度、绝佳的抓取性能、简易的可视化操作、智能的自动化采集,使企业能够以很少的人工成本,快速获取互联网中结构化或非结构化的数据。
软件几乎可以采集互联网上所有公开的数据,通过可视化的操作流程,从建表、过滤、采集到入库一步到位。
支持正则表达式操作,更有强大的面向对象的脚本语言系统。
台式机单机采集能力可达4000-8000万,日采集能力超过500万。
服务器单机集群环境的采集能力可达8亿-16亿,日采集能力超过4000万。
并行情况下可支撑百亿以上规模数据链接,堪与百度等搜索引擎系统媲美。
l?软件特点 一.通用性:可以抓取互联网上几乎100 %的数据 1.支持数据挖掘功能,挖掘全网数据。
2.支持用户登录。
3.支持Cookie技术。
4.支持验证码识别。
5.支持HTTPS安全协议。
6.支持OAuth认证。
7.支持POST请求。
8.支持搜索栏的关键词搜索采集。
9.支持JS动态生成页面采集。
10.支持IP代理采集。
11.支持图片采集。
12.支持本地目录采集。
13.内置面向对象的脚本语言系统,配置脚本可以采集几乎100%的互联网信息。
二.高质量数据:采集+挖掘+清洗+排重一步到位 1.独立知识产权JS引擎,精准采集。
2.集成数据挖掘功能,可以精确挖掘全网关键词信息。
3.内部集成数据库,数据直接采集入库,入库前自动进行两次数据排重。
4.内部创建数据表结构,抓取数据后直接存入数据库相应字段。
5.根据dom结构自动过滤无关信息。
6.通过模板配置链接抽取和数据抽取,目标网站的所有可见内容均可采集,智能过滤无关信息。
7.采集前数据可预览采集,随时调整模板配置,提升数据精度和质量。
8.字段的数据支持多种处理方式。
9.支持正则表达式,精准处理数据。
10.支持脚本配置,精确处理字段的数据。
三.高性能:千万级的采集速度 1.C++编写的爬虫,具备绝佳采集性能。
2.支持多线程采集。
3.台式机单机采集能力可达4000-8000万,日采集能力超过500万。
4.服务器单机集群环境的采集能力可达8亿-16亿,日采集能力超过4000万。
5.并行情况下可支撑百亿以上规模数据链接,堪与百度等搜索引擎系统媲美。
6.软件性能稳健,稳定性好。
四.简易高效:节约70%的配置时间 1.完全可视化的配置界面,操作流程顺畅简易。
2.基本不需要计算机基础,代码薄弱人员也可快速上手,降低操作门槛,节省企业爬虫工程师成本。
3.过滤采集入库一步到位,集成表结构配置、链接过滤、字段取值、采集预览、数据入库。
4.数据智能排重。
5.内置浏览器,字段取值直接在浏览器上可视化定位。
五.?数据管理:多次排重 1.?内置数据库,数据采集完毕直接存储入库。
2.?在软件内部创建数据表和数据字段,直接关联数据库。
3.?采集数据时配置数据模板,网页数据直接存入对应数据表的相应字段。
4.?正式采集之前预览采集结果,有问题及时修正配置。
5.?数据表可导出为csv格式,在Excel工作表中浏览。
6.?数据可智能排除,二次清洗过滤。
六.?智能:智能模拟用户和浏览器行为 1.智能模拟浏览器和用户行为,突破反爬虫限制。
2.自动抓取网页的各类参数和下载过程的各类参数。
3.支持动态IP代理加速,智能过滤无效IP代理,提升代理的利用效率和采集质量。
4.支持动态调整数据抓取策略,多种策略让您的数据无需重采,不再担心漏采,数据采集更智能。
5.自动定时采集。
6.设置采集任务条数,自动停止采集。
7.设置文件大小阈值,自动过滤超大文件。
8.自由设置浏览器是否加速,自动过滤页面的flash等无关内容。
9.智能定位字段取值区域。
10.可以根据字符串特征自动定位取值区域。
11.智能识别表格的多值,表格数据可以完美存入相应字段。
七.?优质服务 1.数据采集完全在本地进行,保证数据安全性。
2.提供大量免费的各个网站配置模板在线下载,用户可以自由导入导出。
3.免费升级后续不断开发的更多功能。
4.为用户提供各类高端定制化服务,全方位来满足用户的数据需求。
有哪些网站用爬虫爬取能得到很有价值的数据
一般有一下几种 一些常用的方法 IP代理 对于IP代理,各个语言的Native Request API都提供的IP代理响应的API, 需要解决的主要就是IP源的问题了. 网络上有廉价的代理IP(1元4000个左右), 我做过简单的测试, 100个IP中, 平均可用的在40-60左右, 访问延迟均在200以上. 网络有高质量的代理IP出售, 前提是你有渠道. 因为使用IP代理后, 延迟加大, 失败率提高, 所以可以将爬虫框架中将请求设计为异步, 将请求任务加入请求队列(RabbitMQ,Kafka,Redis), 调用成功后再进行回调处理, 失败则重新加入队列. 每次请求都从IP池中取IP, 如果请求失败则从IP池中删除该失效的IP. Cookies 有一些网站是基于cookies做反爬虫, 这个基本上就是如 @朱添一 所说的, 维护一套Cookies池 注意研究下目标网站的cookies过期事件, 可以模拟浏览器, 定时生成cookies 限速访问 像开多线程,循环无休眠的的暴力爬取数据, 那真是分分钟被封IP的事, 限速访问实现起来也挺简单(用任务队列实现), 效率问题也不用担心, 一般结合IP代理已经可以很快地实现爬去目标内容. 一些坑 大批量爬取目标网站的内容后, 难免碰到红线触发对方的反爬虫机制. 所以适当的告警提示爬虫失效是很有必有的. 一般...一般有一下几种 一些常用的方法 IP代理 对于IP代理,各个语言的Native Request API都提供的IP代理响应的API, 需要解决的主要就是IP源的问题了. 网络上有廉价的代理IP(1元4000个左右), 我做过简单的测试, 100个IP中, 平均可用的在40-60左右, 访问延迟均在200以上. 网络有高质量的代理IP出售, 前提是你有渠道. 因为使用IP代理后, 延迟加大, 失败率提高, 所以可以将爬虫框架中将请求设计为异步, 将请求任务加入请求队列(RabbitMQ,Kafka,Redis), 调用成功后再进行回调处理, 失败则重新加入队列. 每次请求都从IP池中取IP, 如果请求失败则从IP池中删除该失效的IP. Cookies 有一些网站是基于cookies做反爬虫, 这个基本上就是如 @朱添一 所说的, 维护一套Cookies池 注意研究下目标网站的cookies过期事件, 可以模拟浏览器, 定时生成cookies 限速访问 像开多线程,循环无休眠的的暴力爬取数据, 那真是分分钟被封IP的事, 限速访问实现起来也挺简单(用任务队列实现), 效率问题也不用担心, 一般结合IP代理已经可以很快地实现爬去目标内容. 一些坑 大批量爬取目标网站的内容后, 难免碰到红线触发对方的反爬虫机制. 所以适当的告警提示爬虫失效是很有必有的. 一般被反爬虫后, 请求返回的HttpCode为403的失败页面, 有些网站还会返回输入验证码(如豆瓣), 所以检测到403调用失败, 就发送报警, 可以结合一些监控框架, 如Metrics等, 设置短时间内, 告警到达一定阀值后, 给你发邮件,短信等. 当然, 单纯的检测403错误并不能解决所有情况. 有一些网站比较奇葩, 反爬虫后返回的页面仍然是200的(如去哪儿), 这时候往往爬虫任务会进入解析阶段, 解析失败是必然的. 应对这些办法, 也只能在解析失败的时候, 发送报警, 当告警短时间到达一定阀值, 再触发通知事件. 当然这个解决部分并不完美, 因为有时候, 因为网站结构改变, 而导致解析失败, 同样回触发告警. 而你并不能很简单地区分, 告警是由于哪个原因引起的.爬虫代理服务器怎么用
打开火狐浏览器右上角的设置选项,选择“选项” 爬虫代理服务器怎么用? 选择左边选项栏中最下方的“高级”选项 爬虫代理服务器怎么用? “高级”选项下拉菜单“网络”。连接配置 Firefox 如何连接至国际互联网,右侧的“设置网络” 爬虫代理服务器怎么用? 在菜单中选择“手动选择配置代理” 爬虫代理服务器怎么用? 将您的http代理IP地址填写在IP地址栏内,端口代码写在相应的位置。
其他的代理SSL代理、FTP代理、socks主机都类似。
爬虫代理服务器怎么用? END 注意事项 其他浏览器的处理方法差不多,选择代理IP一定要选择高质量的代理IP,否则就是在浪费时间。
诸如讯代理、蚂蚁代理、快代理这些网站所提供的代理IP的质量都还不错。
每个代理提供商有自己的特色,可以多加尝试!
- 讯代理爬虫爬虫代理服务器怎么用相关文档
- 讯代理爬虫什么是网络爬虫
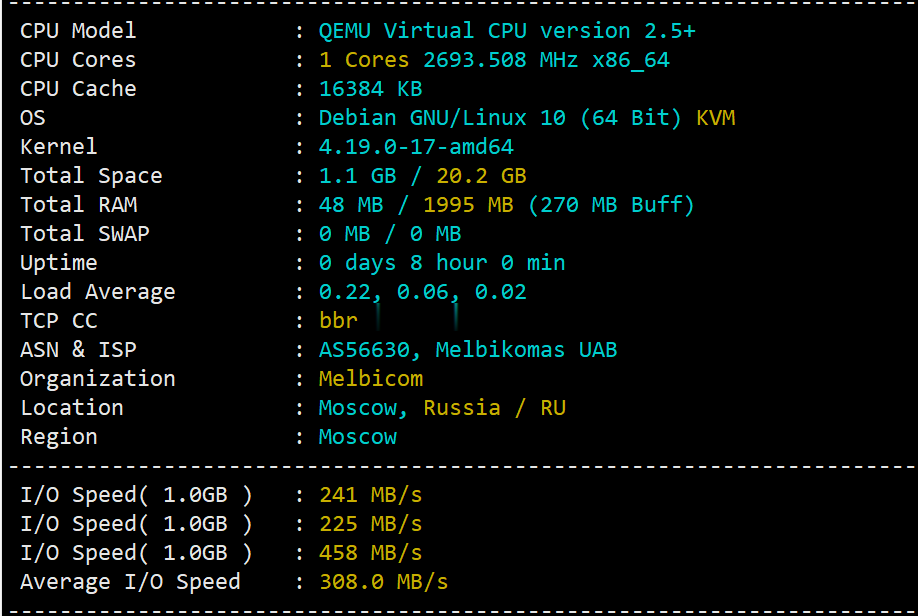
简单测评melbicom俄罗斯莫斯科数据中心的VPS,三网CN2回国,电信双程cn2
melbicom从2015年就开始运作了,在国内也是有一定的粉丝群,站长最早是从2017年开始介绍melbicom。上一次测评melbicom是在2018年,由于期间有不少人持续关注这个品牌,而且站长貌似也听说过路由什么的有变动的迹象。为此,今天重新对莫斯科数据中心的VPS进行一次简单测评,数据仅供参考。官方网站: https://melbicom.net比特币、信用卡、PayPal、支付宝、银联...
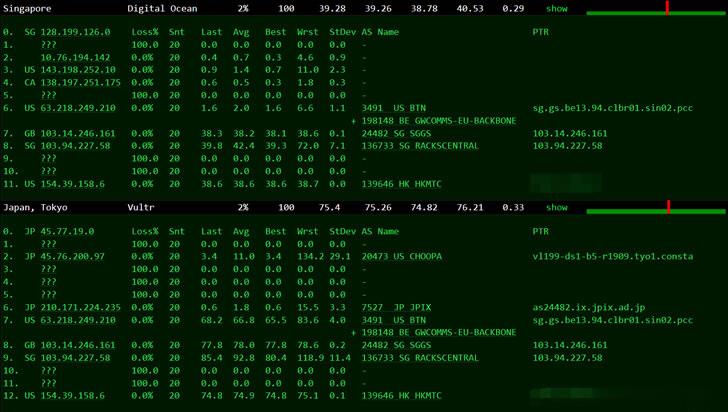
Megalayer新加坡服务器国际带宽线路测评
前几天有关注到Megalayer云服务器提供商有打算在月底的时候新增新加坡机房,这个是继美国、中国香港、菲律宾之外的第四个机房。也有工单询问到官方,新加坡机房有包括CN2国内优化线路和国际带宽,CN2优化线路应该是和菲律宾差不多的。如果我们追求速度和稳定性的中文业务,建议还是选择CN2优化带宽的香港服务器。这里有要到Megalayer新加坡服务器国际带宽的测试服务器,E3-1230配置20M国际带...
韩国服务器租用优惠点评大全
韩国服务器怎么样?韩国云服务器租用推荐?韩国服务器距离中国近,有天然的地域优势,韩国服务器速度快而且非常稳定!有不少有亚洲市场的外贸公司选择韩国服务器开拓业务,韩国服务器因自身的优势也受到不少用户的青睐。目前的IDC市场上,韩国、香港、美国三个地方的服务器几乎占据了海外服务器的百分之九十以上。韩国服务器相比美国服务器来说速度更快,而相比香港机房来说则带宽更充足,占用市场份额非常大。那么,韩国服务器...
讯代理爬虫为你推荐
-
华为云桌面国内主流的桌面云产品有哪些?美国代购网站哪个好海淘网站哪个好 美国学生腾讯云学生医保跟普通医保有什么区别阿里云服务器账号密码如何修改阿里云服务器密码虚拟主机下载虚拟机怎么下载 给具体方法 成功追分的#11徐正溪痕迹电视剧郑晓炯是谁饰演?国外服务器怎么租怎么使用国外的服务器佛山服务器租用服务器租用哪家好建站云服务器云服务器建站有何优势商城域名中文.商城域名为什么有投资价值?