字节UTF到Unicode的编码转换(DOC X页)
UTF-8就是Unicode Transformation Format-8是Unicode的一种变换编码格式。
UTF-8有以下特性:
UCS字符U+0000到U+007F(ASCII)被编码为字节0x00到0x7F(ASCII兼容).这意味着只包含7位ASCII字符的文件在ASCII和UTF-8两种编码方式下是一样的.
所有>U+007F的UCS字符被编码为一个多个字节的串,每个字节都有标记位集.因此,ASCII字节(0x00-0x7F)不可能作为任何其他字符的一部分.
表示非ASCII字符的多字节串的第一个字节总是在0xC0到0xFD的范围里,并指出这个字符包含多少个字节.多字节串的其余字节都在0x80到0 xBF范围里.这使得重新同步非常容易,并使编码无国界,且很少受丢失字节的影响.
可以编入所有可能的231个UC S代码
UTF-8编码字符理论上可以最多到6个字节长,然而16位B MP字符最多只用到3字节长.
Bigendian UCS-4字节串的排列顺序是预定的.
字节0xFE和0xFF在UTF-8编码中从未用到.
下列字节串用来表示一个字符.用到哪个串取决于该字符在Unicode中的序号.
U-00000000 - U-0000007F: 0xxxxxxx
U-00000080 - U-000007FF: 110xxxxx 10xxxxxx
U-00000800 - U-0000FFFF: 1110xxxx 10xxxxxx 10xxxxxx
U-00010000 - U-001FFFFF: 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx
U-00200000 - U-03FFFFFF: 111110xx 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx
U-04000000 - U-7FFFFFFF: 1111110x 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx10xxxxxx从上表还可以看出 UTF-8每个编码字符都不可能以“10”开头 “10”是以连接符的形式出现在后面的编码字节开头。因此UTF-8编码在存储和传输时是不容易出错的。
下面是UTF-8到Unicode的编码转换代码(J2 ME环境下的实现)UTFC2UniC方法包含了编码转换逻辑。/**
*将UTF-8字节数据转化为Unicode字符串
*@p aram ut f_data b yte[] -U TF-8编码字节数组
*@param len int -字节数组长度
*@return String-变换后的Unicode编码字符串
*/pub lic static String UTF2Uni(byte[]utf_data, int len){
StringBuffer unis=new StringBuffer();char unic=0;int ptr=0;int c ntB its=0;fo r(;p tr<len;)
{cntB its=getC ntB its(ut f_da ta[ptr]);if(c ntB its==-1)
{
++ptr;c o nt inue;
}elseif(c ntB its==0)
{unic=UTFC2UniC(utf_data,ptr,cntB its);
++ptr;
}else
{unic=UTFC2UniC(utf_data,ptr,cntB its);ptr+=cntBits;
}unis.appe nd(unic);
}return unis.to S tring();
}
/**
*将指定的UTF-8字节组合成一个Unicode编码字符
*@p aram ut f b yte[] -UTF-8字节数组
*@param sptr int -编码字节起始位置
*@param cntB its int -编码字节数
*@return char-变换后的Unicode字符
*/pub lic static char UTFC2UniC(byte[]utf, int sptr, int cntBits)
{
/*
Unicode<->UTF-8
U-00000000-U-0000007F: 0 xxxxxxx
U-00000080-U-000007FF: 110xxxxx 10 xxxxxx
U-00000800-U-0000FFFF: 1110xxxx 10xxxxxx 10xxxxxx
U-00010000-U-001 FFFFF: 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx
U-00200000-U-03FFFFFF: 111110xx 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx
U-04000000-U-7FFFFFFF: 1111110x 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx 10xxxxxx
*/int uniC=0; // repre sent the unicode charbyte firstByte=utf[sptr];int ptr=0; // po inter 0~15
//resolve single byte UTF-8 encoding charif(c ntB its==0)return(c har)fir stByte;
//re so lve the first bytefirs tB yte&=(1<<(7-c nt B its)) - 1;
//resolve multiple bytes UTF-8 encoding char(except the first byte)fo r(int i=sptr+c ntB its - 1; i>sp tr; --i)
{byte utfb=utf[i];uniC|=(utfb&0x3 f)<<ptr;ptr+=6;
}uniC|=fir stB yte<<p tr;return(c har)uniC;
}
//根据给定字节计算UTF-8编码的一个字符所占字节数
//UTF-8规则定义字节标记只能为0或2~6
private static int getCntBits(byte b)
{int cnt=0;i f(b==0)re t ur n-1;for(int i=7; i>=0; --i)
{if(((b>>i)&0x1)==1)
++cnt;elseb re ak;
}return(cnt>6| |cnt==1)?-1 :cnt;
}
参考资料
《UTF-8 and Unicode FAQ》——http://www.linuxforum.net/books/UTF-8-Unicode.html
- 字节UTF到Unicode的编码转换(DOC X页)相关文档
- 函数unicode编码转换
- 汉字unicode编码转换
- 编码unicode编码转换
- 转换unicode编码转换
- 转换为unicode编码转换
- 编码高效Unicode_GB编码转换算法的设计和实现
wordpress外贸企业主题 wordpress高级全行业大气外贸主题
wordpress高级全行业大气外贸主题,wordpress通用全行业高级外贸企业在线询单自适应主题建站程序,完善的外贸企业建站功能模块 + 高效通用的后台自定义设置,更实用的移动设备特色功能模块 + 更适于欧美国外用户操作体验 大气简洁的网站风格设计 + 高效优化的网站程序结构,更利于Goolge等SEO搜索优化和站点收录排名。点击进入:wordpress高级全行业大气外贸主题主题价格:¥398...
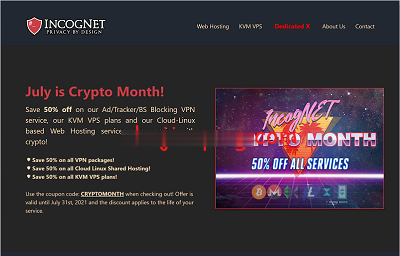
incogne$2.5/月t芬兰VPS,AMD Ryzen、1Gbps带宽
IncogNet LLC是个由3个人运作的美国公司,主要特色是隐私保护,号称绝对保护用户的隐私安全。业务涵盖虚拟主机、VPS等,支持多种数字加密货币、PayPal付款。注册账号也很简单,输入一个姓名、一个邮箱、国家随便选,填写一个邮箱就搞定了,基本上不管资料的真假。当前促销的vps位于芬兰机房,全部都是AMD Ryzen系列的CPU,性能不会差的!5折优惠码:CRYPTOMONTH,支持:BTC,...
NameCheap域名转入优惠再次来袭 搜罗今年到期域名续费
在上个月的时候也有记录到 NameCheap 域名注册商有发布域名转入促销活动的,那时候我也有帮助自己和公司的客户通过域名转入到NC服务商这样可以实现省钱续费的目的。上个月续费转入的时候是选择9月和10月份到期的域名,这不还有几个域名年底到期的,正好看到NameCheap商家再次发布转入优惠,所以打算把剩下的还有几个看看一并转入进来。活动截止到9月20日,如果我们需要转入域名的话可以准备起来。 N...
-
新低iosmediawikiwiki,wikipedia与mediawiki三者的区别cuteftpCuteFTP 和FlashFXP是什么软件,有什么功能,怎样使用?sqlserver数据库SQL SERVER数据库是可以做什么用的?什么是支付宝支付宝是什么意思?360arp防火墙在哪360的9.6版本ARP防火墙在哪?netshwinsockreset游戏出现battlEye Launcher 怎么办flashfxp注册码谁有~FLASHfxp V3.0.2的注册码~~谢谢哦!!要现在能用的!!!!宜人贷官网宜人贷是不是骗人的银花珠树晓来看关于下雪景的诗句