数据挖掘原理与算法数据仓库与数据挖掘的原理是什么?
数据挖掘与算法是什么关系
1.数据挖掘是指从大量的数据中通过算法搜索隐藏于其中信息的过程。数据挖掘通常与计算机科学有关,并通过统计、在线分析处理、情报检索、机器学习、专家系统(依靠过去的经验法则)和模式识别等诸多方法来实现上述目标。
2.算法是一种描述程序行为的语言,是一种让程序最为简洁的思考方式。
是指解题方案的准确而完整的描述,是一系列解决问题的清晰指令,算法代表着用系统的方法描述解决问题的策略机制。
3.数据挖掘算法是根据数据创建数据挖掘模型的一组试探法和计算。
为了创建模型,算法将首先分析您提供的数据,并查找特定类型的模式和趋势。
算法使用此分析的结果来定义用于创建挖掘模型的最佳参数。
然后,这些参数应用于整个数据集,以便提取可行模式和详细统计信息。
数据挖掘算法是做什么的
算法是利用计算机解决问题的处理步骤,简而言之,算法就是解决问题的步骤。算法必须具备两个重要条件: 有效性:算法必须要为给定的任务给出正确的结果,即,有满足条件的输入值时,此算法一定要保证正常工作(返回正确的输出值)。
表明算法有效性的方法之一就是断点。
断点设置在算法的任意位置上,判断此位置是否满足给出的条件,即,程序是否正确运行。
终止性:算法中没有永远反复执行,即,没有无限循环,且不返回答案的情况。
算法终止性可以用反复处理结束条件的判断变量,或经过有限次的反复一定能到达结束条件等方法证明。
【数据挖掘】我想知道数据挖掘算法到底是怎么一回事?
展开全部 按我的理解,数据挖掘是一种处理数据,提取数据之间关系的技术。做数据挖掘可分为两种,一种基于算法的研究和程序实现,一种基于数据挖掘软件,例如:SAS、SPSS Clementine。
数据挖掘包含的那些算法其实是对数据做处理的一种方式,比如聚类算法,就是将一堆数据聚为几类,而如何完成聚类就要靠算法的应用程序来实现。
你理解的应用程序里面提取数据的方式是按照算法来的,是对的,但是得对应相应的算法。
数据挖掘 算法
第一题结果:
#include <stdio.h>
#define DATALEN 27
int data[DATALEN]=
{13, 15, 16,
16, 19, 20,
20, 21, 22,
22, 25, 25,
25, 25, 30,
33, 33, 35,
35, 35, 35,
36, 40, 45,
46, 52, 70};
int nSmoothByMeans[DATALEN]={0};
int nSmoothByMedians[DATALEN]={0};
int nSmoothByBoundaries[DATALEN]={0};
void SmoothByMeans(int depth)
{
int i=0,j=0;
int sum=0 , mean=0;
for(i=0;i<27;i=i+3)
{
for (j=i;j<i+depth;j++)
{
sum+=data[j];
}
mean = sum/depth;
for (j=i;j<i+depth;j++)
{
nSmoothByMeans[j]=mean;
}
sum = 0;
}
}
void SmoothByMedians(int depth)
{
int i=0,j=0;
for(i=1;i<27;i=i+3)
{
for (j=i-1;j<i+depth;j++)
{
nSmoothByMedians[j]=data[i];
}
}
}
void SmoothByBoundaries(int depth)
{
int i=0,j=0;
for(i=0;i<27;i++)
{
nSmoothByBoundaries[i]=data[i];
}
for (i=1;i<27;i=i+3)
{
if (data[i]-data[i-1]>data[i+1]-data[i])
{
nSmoothByBoundaries[i]=data[i+1];
}
else
{
nSmoothByBoundaries[i]=data[i-1];
}
}
}
void main()
{
int depth = 3;
int i=0;
int j=0;
SmoothByMeans(3);
SmoothByMedians(3);
SmoothByBoundaries(3);
printf("原始数据: ");
for(i=0,j=1;i<27;i=i+3,++j)
{
printf("Bin %d : %d,%d,%d ",
j,data[i],data[i+1],data[i+2]);
}
printf("使用平均值: ");
for(i=0,j=1;i<27;i=i+3,++j)
{
printf("Bin %d : %d,%d,%d ",
j,nSmoothByMeans[i],nSmoothByMeans[i+1],nSmoothByMeans[i+2]);
}
printf("使用中值: ");
for(i=0,j=1;i<27;i=i+3,++j)
{
printf("Bin %d : %d,%d,%d ",
j,nSmoothByMedians[i],nSmoothByMedians[i+1],nSmoothByMedians[i+2]);
}
printf("使用边界值: ");
for(i=0,j=1;i<27;i=i+3,++j)
{
printf("Bin %d : %d,%d,%d ",
j,nSmoothByBoundaries[i],nSmoothByBoundaries[i+1],nSmoothByBoundaries[i+2]);
}
}
数据挖掘算法有哪些
国际权威的学术组织the IEEE International Conference on Data Mining (ICDM) 2006年12月评选出了数据挖掘领域的十大经典算法:C4.5, k-Means, SVM, Apriori, EM, PageRank, AdaBoost, kNN, Naive Bayes, and CART. 不仅仅是选中的十大算法,其实参加评选的18种算法,实际上随便拿出一种来都可以称得上是经典算法,它们在数据挖掘领域都产生了极为深远的影响。1. C4.5 C4.5算法是机器学习算法中的一种分类决策树算法,其核心算法是ID3算法. C4.5算法继承了ID3算法的优点,并在以下几方面对ID3算法进行了改进: 1) 用信息增益率来选择属性,克服了用信息增益选择属性时偏向选择取值多的属性的不足; 2) 在树构造过程中进行剪枝; 3) 能够完成对连续属性的离散化处理; 4) 能够对不完整数据进行处理。
C4.5算法有如下优点:产生的分类规则易于理解,准确率较高。
其缺点是:在构造树的过程中,需要对数据集进行多次的顺序扫描和排序,因而导致算法的低效。
2. The k-means algorithm 即K-Means算法 k-means algorithm算法是一个聚类算法,把n的对象根据他们的属性分为k个分割,k < n。
它与处理混合正态分布的最大期望算法很相似,因为他们都试图找到数据中自然聚类的中心。
它假设对象属性来自于空间向量,并且目标是使各个群组内部的均 方误差总和最小。
3. Support vector machines 支持向量机,英文为Support Vector Machine,简称SV机(论文中一般简称SVM)。
它是一种监督式学习的方法,它广泛的应用于统计分类以及回归分析中。
支持向量机将向量映射到一个更 高维的空间里,在这个空间里建立有一个最大间隔超平面。
在分开数据的超平面的两边建有两个互相平行的超平面。
分隔超平面使两个平行超平面的距离最大化。
假 定平行超平面间的距离或差距越大,分类器的总误差越小。
一个极好的指南是C.J.C Burges的《模式识别支持向量机指南》。
van der Walt 和 Barnard 将支持向量机和其他分类器进行了比较。
4. The Apriori algorithm Apriori算法是一种最有影响的挖掘布尔关联规则频繁项集的算法。
其核心是基于两阶段频集思想的递推算法。
该关联规则在分类上属于单维、单层、布尔关联规则。
在这里,所有支持度大于最小支持度的项集称为频繁项集,简称频集。
5. 最大期望(EM)算法 在统计计算中,最大期望(EM,Expectation–Maximization)算法是在概率(probabilistic)模型中寻找参数最大似然 估计的算法,其中概率模型依赖于无法观测的隐藏变量(Latent Variabl)。
最大期望经常用在机器学习和计算机视觉的数据集聚(Data Clustering)领域。
6. PageRank PageRank是Google算法的重要内容。
2001年9月被授予美国专利,专利人是Google创始人之一拉里·佩奇(Larry Page)。
因此,PageRank里的page不是指网页,而是指佩奇,即这个等级方法是以佩奇来命名的。
PageRank根据网站的外部链接和内部链接的数量和质量俩衡量网站的价值。
PageRank背后的概念是,每个到页面的链接都是对该页面的一次投票, 被链接的越多,就意味着被其他网站投票越多。
这个就是所谓的“链接流行度”——衡量多少人愿意将他们的网站和你的网站挂钩。
PageRank这个概念引自 学术中一篇论文的被引述的频度——即被别人引述的次数越多,一般判断这篇论文的权威性就越高。
7. AdaBoost Adaboost是一种迭代算法,其核心思想是针对同一个训练集训练不同的分类器(弱分类器),然后把这些弱分类器集合起来,构成一个更强的最终分类器 (强分类器)。
其算法本身是通过改变数据分布来实现的,它根据每次训练集之中每个样本的分类是否正确,以及上次的总体分类的准确率,来确定每个样本的权 值。
将修改过权值的新数据集送给下层分类器进行训练,最后将每次训练得到的分类器最后融合起来,作为最后的决策分类器。
8. kNN: k-nearest neighbor classification K最近邻(k-Nearest Neighbor,KNN)分类算法,是一个理论上比较成熟的方法,也是最简单的机器学习算法之一。
该方法的思路是:如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类别。
9. Naive Bayes 在众多的分类模型中,应用最为广泛的两种分类模型是决策树模型(Decision Tree Model)和朴素贝叶斯模型(Naive Bayesian Model,NBC)。
朴素贝叶斯模型发源于古典数学理论,有着坚实的数学基础,以 及稳定的分类效率。
同时,NBC模型所需估计的参数很少,对缺失数据不太敏感,算法也比较简单。
理论上,NBC模型与其他分类方法相比具有最小的误差率。
但是实际上并非总是如此,这是因为NBC模型假设属性之间相互独立,这个假设在实际应用中往往是不成立的,这给NBC模型的正确分类带来了一定影响。
在属 性个数比较多或者属性之间相关性较大时,NBC模型的分类效率比不上决策树模型。
而在属性相关性较小时,NBC模型的性能最为良好。
10. CART: 分类与回归树 CART, Classification and Regression Trees。
在分类树下面有两个关键的思想。
第一个是关于递归地划分自变量空间的想法;第二个想法是用验证数据进行剪枝。
数据仓库与数据挖掘的原理是什么?
进入信息社会以来,信息技术经历了这样的发展过程:从计算机主机的信息集中处理方式到个人计算机(PC)的信息分布处理形式的转变;从单一的计算机操作系统到计算机互联网络操作的改变;从客户机/服务器(Client/Server)计算体系到多层体系结构计算模式的转变;从单一数据库到大型数据仓库和从局域网到的改变。现代信息技术的发展和现代科学技术的进步,使人类迈入了新的时期——信息化时代。
信息处理技术的发展,使得各类数据、信息急剧增长,给数据的传输、存储带来了许多新的问题,特别是由于各类不同事务产生大量不同类型的数据,这些数据分别被各个时期建立的许多应用系统所使用。
人们希望能够看到所有数据和信息的综合情况,而这些数据和信息有许多不能被统一描述,不能被现有应用系统综合使用。
针对这一问题,人们设想专门为业务的统计分析建立一个数据中心,它的数据来自联机的事务处理系统、异构的外部数据源、脱机的历史业务数据等,这个数据中心就叫数据仓库。
数据仓库技术的应运而生,成为信息技术领域非常热门的话题之一。
数据仓库技术的提出,建立了一种体系化的数据存储环境,将分析决策所需要的大量数据从传统的操作环境中分离出来,使分散、不一致的操作数据转换成集成、统一的信息。
企业内不同单位、不同角色的成员都可以在此单一的环境之下,通过运用其中的数据与信息,发现全新的视野和新的问题,产生用于决策的新分析方法。
作为决策支持系统的重要组成部分,数据仓库为决策支持系统提供了分析决策所需的数据;OLAP的产生进一步增强了决策支持系统快速、一致和交互性的分析能力,它利用存储在数据仓库中的数据完成各种分析操作,并以直观易懂的形式将分析结果展现给决策分析人员;而数据挖掘是从大量数据中提取或“挖掘”知识,从而实现从“数据→信息→知识”的过程,为企业的管理层提供各种层次的决策支持。
- 数据挖掘原理与算法数据仓库与数据挖掘的原理是什么?相关文档
- 数据挖掘原理与算法数据挖掘里面最简单的算法是什么
- 数据挖掘原理与算法数据挖掘参考文献有哪些
Digital-VM:服务器,$80/月;挪威/丹麦英国/Digital-VM:日本/新加坡/digital-vm:日本VPS仅$2.4/月
digital-vm怎么样?digital-vm在今年1月份就新增了日本、新加坡独立服务器业务,但是不知为何,期间终止了销售日本服务器和新加坡服务器,今天无意中在webhostingtalk论坛看到Digital-VM在发日本和新加坡独立服务器销售信息。服务器硬件是 Supermicro、采用最新一代 Intel CPU、DDR4 RAM 和 Enterprise Samsung SSD内存,默认...
HostYun 新增美国三网CN2 GIA VPS主机 采用美国原生IP低至月15元
在之前几个月中也有陆续提到两次HostYun主机商,这个商家前身是我们可能有些网友熟悉的主机分享团队的,后来改名称的。目前这个品牌主营低价便宜VPS主机,这次有可以看到推出廉价版本的美国CN2 GIA VPS主机,月费地址15元,适合有需要入门级且需要便宜的用户。第一、廉价版美国CN2 GIA VPS主机方案我们可看到这个类型的VPS目前三网都走CN2 GIA网络,而且是原生IP。根据信息可能后续...

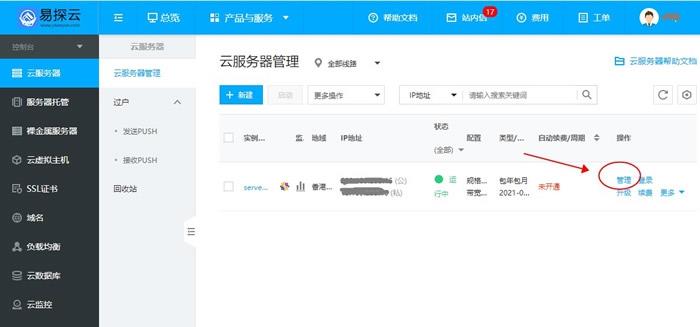
易探云服务器怎么过户/转让?云服务器PUSH实操步骤
易探云服务器怎么过户/转让?易探云支持云服务器PUSH功能,该功能可将云服务器过户给指定用户。可带价PUSH,收到PUSH请求的用户在接收云服务器的同时,系统会扣除接收方的款项,同时扣除相关手续费,然后将款项打到发送方的账户下。易探云“PUSH服务器”的这一功能,可以让用户将闲置云服务器转让给更多需要购买的用户!易探云服务器怎么过户/PUSH?1.PUSH双方必须为认证用户:2.买家未接收前,卖家...
-
spotlight搜索是什么如何启动Spotlight搜索dnf客户端消失DNF客户端无缘无故消失微信语音在哪个文件夹微信时的语音聊天记录保存在哪一个文件夹人脸检测综述mtcnn论文中的人脸检测达到了什么样的水准linux操作系统好吗linux好用不?云图好看吗电影《云图》到底讲的什么,没看懂,高手来说一下。handoff怎么用iphone handoff怎么用联通玩电信游戏我朋友是联通的网,想玩电信的游戏但是发现都很卡微软永久关闭实体店如何注销微软账户cad图批量打印在cad中如何进行批量打印